 LIVE INFERENCE ACTIVE
实时状态:DeepSeek-R1 网页端思考链满血版集群就绪,响应时延低至毫秒级
deepseek 网页版入口
免配置、即开即用。欢迎进入 DeepSeek网页版 官方交互工作台,在此体验纯强化学习驱动的透明思维链展开与全能推理服务。
用户:请分析 DeepSeek 纯强化学习在无需海量监督数据冷启动下的自我演化逻辑?
▶ 思考链 (Thinking Process):
1. 正在检索 DeepSeek-R1 纯强化学习 (Pure RL) 的核心机制;
2. 分析大规模自我博弈 (Self-Play) 中奖励函数设计的鲁棒性;
3. 模型在无需人类监督数据辅助下,自主衍生出“反思、重新验证、逐步检验”等思维链行为。
DeepSeek AI 回答:1. 正在检索 DeepSeek-R1 纯强化学习 (Pure RL) 的核心机制;
2. 分析大规模自我博弈 (Self-Play) 中奖励函数设计的鲁棒性;
3. 模型在无需人类监督数据辅助下,自主衍生出“反思、重新验证、逐步检验”等思维链行为。
在纯强化学习阶段,DeepSeek 探索了大型语言模型摆脱对人类标注微调数据依赖的可能性。通过精心设计的规则驱动型奖励(Rule-based Reward),模型能够在大规模数理验证与代码编译中自主探索正确解法,逐步涌现出自主纠错机制,标志着向人工通用智能迈出了决定性的一步。
FEATURE // 01
多轮长程记忆保持
最高支持 64K 超长上下文窗口,无论是长篇学术文献还是庞大代码工程均可一并解析。
FEATURE // 02
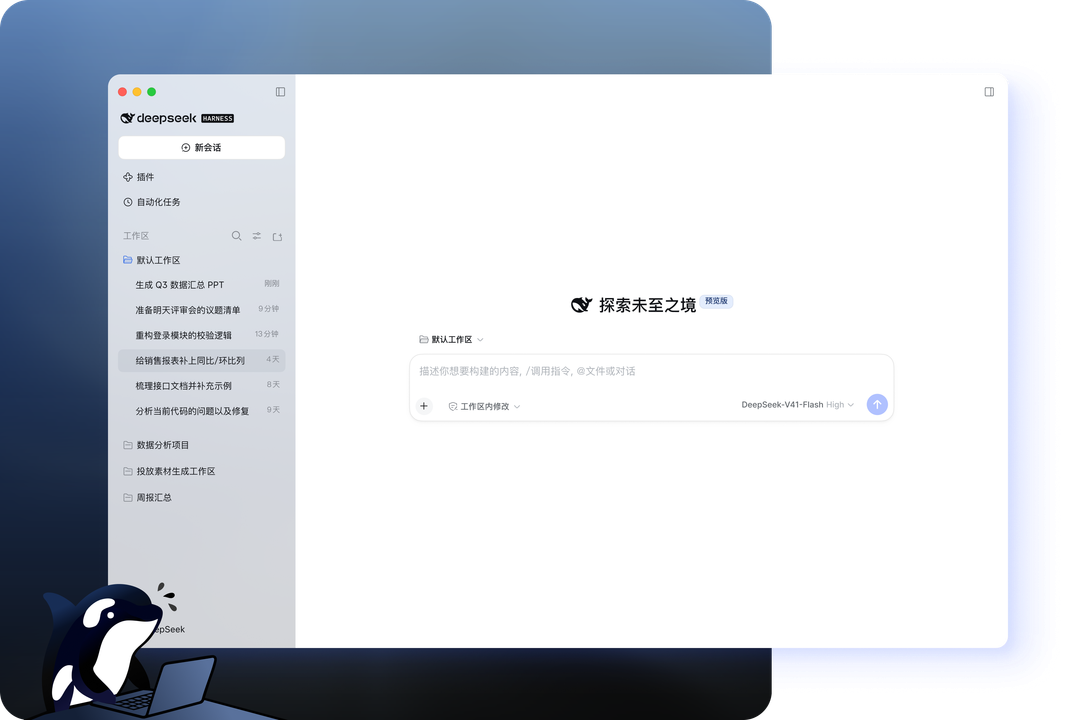
极速代码审计与编写
全面覆盖主流计算机语言,支持复杂算法推演、单元测试生成与安全缺陷排查。
FEATURE // 03
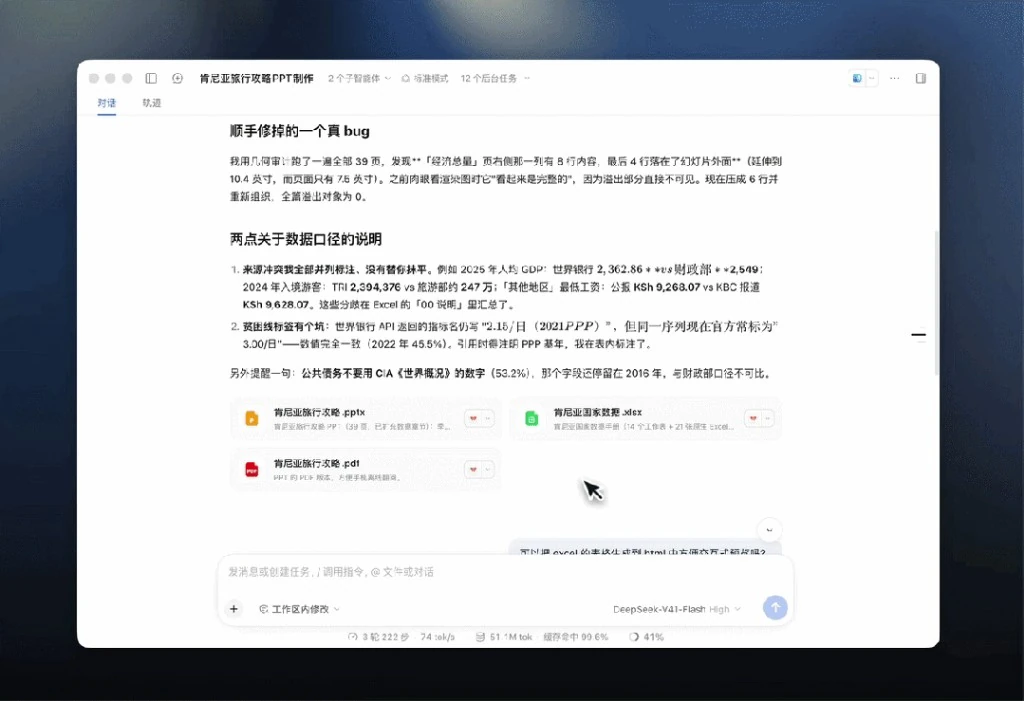
LaTeX 公式严谨渲染
内置标准 LaTeX 引擎,将复杂的微积分方程组与数理推论以清晰优美排版准确展现。
即开即用零配置
无需安装任何本地客户端或繁杂运行时,在现代浏览器中点击 DeepSeek网页版入口 即可立即使用。
纯净隐私安全边界
用户的每一次会话均经过全程链路高等级加密保护,不落盘、不用于后续训练,守护商业秘密。
多端响应自适应
完美适配桌面显示器、平板与手机移动端,在任何设备上均保持一致的冷冽未来交互体验。